Harctérre küldenénk az AI-t, de egyelőre még az emberi viselkedés alapvető mintázatait is félreérti
A nagy nyelvi modellek már számtalan témában képesek meggyőző válaszokat adni, az emberi viselkedés előrejelzése azonban továbbra is komoly kihívást jelent számukra. A Pennsylvaniai Egyetem és a Világbank kutatói arra jutottak, hogy a vizsgált AI-modellek következetesen túlbecsülik, milyen gyakran büntetik vagy ítélik el az emberek a társadalmi normák megsértőit.
A kutatók azt vizsgálták, mennyire egyeznek a nagy nyelvi modellek előrejelzései azzal, ahogyan valódi emberek értékelnek különböző társadalmi helyzeteket. A tanulmány szerint ezen a területen jelentős eltérés mutatkozik.
A korábbi fejlesztések elsősorban arra összpontosítottak, hogy a mesterséges intelligencia felismerje az alapvető társadalmi normákat. Egy modellnek például meg kell értenie, hogy a lopást a társadalom elfogadhatatlannak tartja. A társadalmi intelligenciához azonban ennél többre van szükség.
Az is számít, hogy a modell képes-e megjósolni, ki és milyen módon reagál egy szabály megsértésére: nyilvánosan megszégyeníti az illetőt, pletykálni kezd róla, elkerüli, szembesíti a tettével, esetleg egyáltalán nem tesz semmit. Ezeket a másodrendű társadalmi elvárásokat nevezik metanormáknak. A kutatók saját módszertant dolgoztak ki annak mérésére, mennyire képesek a modellek megérteni ezeket a helyzeteket. Két területet vizsgáltak: milyen érzelmeket tulajdonítanak a normasértőnek és a környezetének, illetve milyen reakciót várnak a szemtanúktól.
Ehhez létrehozták a NormReact nevű adatbázist, amely 450 normasértési helyzetet tartalmaz. A szituációkat ellátták az érzelmekre és a várható viselkedésre vonatkozó jelölésekkel. Figyelembe vették a normasértő nemét, valamint azt is, milyen kapcsolatban áll vele a történteket megfigyelő személy.
Hat nagy nyelvi modellt teszteltek: a GPT-5.2-t, a Claude-4.5-Opust, a Gemini-3-Prót, a GPT-OSS-20B-t, a Llama-4-Scout-17B-t és a Gemma-3-12B-t. Mindegyik modell ugyanazt a 16 kérdésből álló felmérést kapta. A különböző helyzetekben meg kellett becsülniük, milyen érzelmeket élhet át a normasértő, mennyire erősek ezek az érzelmek, hogyan érezhetnek a közeli barátok és rokonok, az ismerősök, illetve az idegenek, mit tesznek várhatóan ezek az emberek, és milyen reakció számít társadalmilag megfelelőnek. Ugyanezekre a kérdésekre emberek is válaszoltak, így közvetlenül össze lehetett vetni az emberi várakozásokat a modellek becsléseivel.
Az eredmény mind a hat vizsgált modellnél ugyanabba az irányba mutatott: az LLM-ek az embereknél gyakrabban számítottak negatív következményekre, például rosszallásra, konfrontációra, pletykára vagy a normasértő kerülésére. Különösen feltűnő volt az eltérés azokban a helyzetekben, amelyekben az emberi válaszadók szerint a környezet várhatóan semmit sem tenne. A modellek ezekben az esetekben is gyakrabban számítottak elítélő vagy büntető reakcióra.
A kutatók megfogalmazása szerint a jelenlegi LLM-ek szigorúbb társadalmi világot ábrázolnak: olyan helyzetekben is negatív szankciókat várnak, amelyekben az emberek inkább tétlenségre számítanak. Az emberi és gépi válaszok közötti összhang ráadásul annál gyengébbé vált, minél nagyobb volt a társadalmi távolság az érintettek között.
Ennek gyakorlati következményei is lehetnek. Ha egy mesterségesintelligencia-rendszert konfliktusok kezelésére, társadalmi folyamatok modellezésére vagy szakpolitikai szimulációkra használnak, a torzítás félrevezető eredményekhez vezethet. A modellek a ténylegesnél nagyobb szerepet tulajdoníthatnak a büntetésnek és az elítélésnek, ezzel párhuzamosan alulbecsülhetik a toleranciát, a visszafogottságot és azt, hogy az emberek reakcióikat a közöttük lévő kapcsolat jellegéhez igazítják.
A kutatás eredményei így új feladatot jelölnek ki a fejlesztőknek: az MI-nek már nem csupán azt kell megtanulnia, milyen szabályokat tartanak be az emberek, hanem azt is, mi történik a valóságban akkor, amikor valaki megszegi őket.
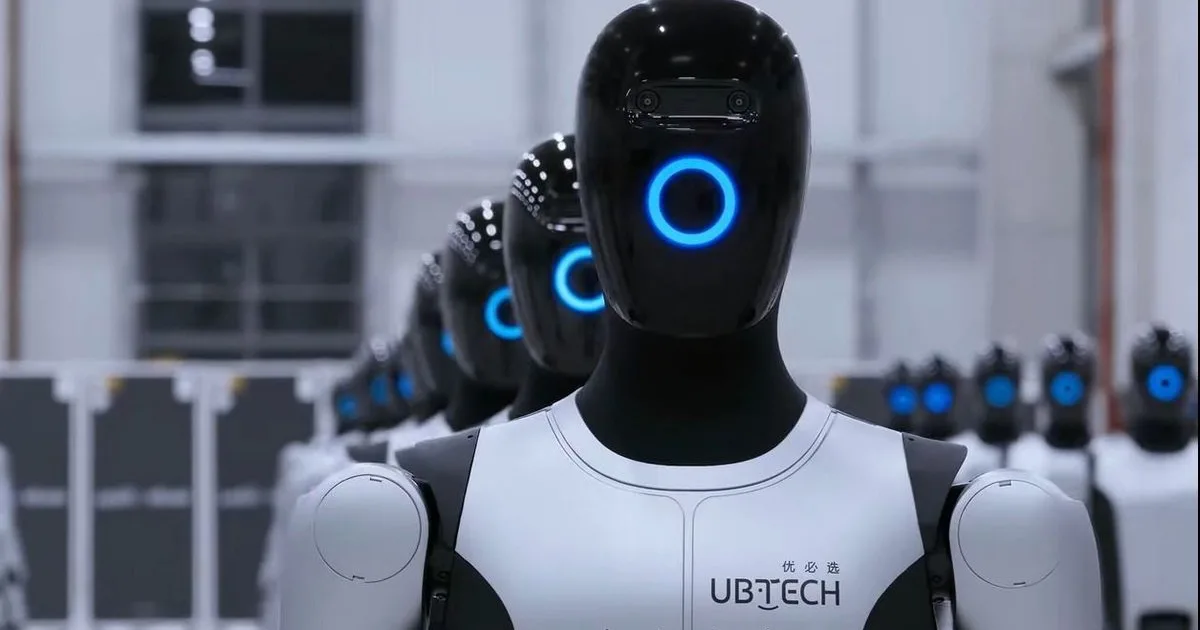
Különös fénytörésbe helyezi a tanulmányt, hogy többek közt Kína és az Egyesült Államok gyors tempóban fejleszti a harctéri körülmények közt bevethető, autonóm döntésekre képes MI-vezérelt robotokat. Korábban már a kínai Népi Felszabadító Hadsereg hivatalos lapja arra szólította fel a kutatókat, hogy gyorsítsák fel a legmodernebb technológiák átadását a laboratóriumokból a katonai gyakorlóterekre, ahol robot harcosok kiképzésére lehet szükség.
Egyelőre még számos technikai akadálya van, hogy robotokat vessenek be éles harci helyzetekben, ugyanakkor egyéb problémák is felmerültek a fejlesztések során. Többek közt megállapították, hogy a humán etika értelmezése is nehézségeket okoz a mesterséges intelligenciának. A Vöröskereszt Nemzetközi Bizottsága például korábban arra figyelmeztetett, hogy az autonóm fegyverek számára különösen nehéz lehet a megadás jeleinek megbízható értelmezése, mivel ehhez gyakran a helyzet, a viselkedés és a szándék együttes értékelése szükséges.
